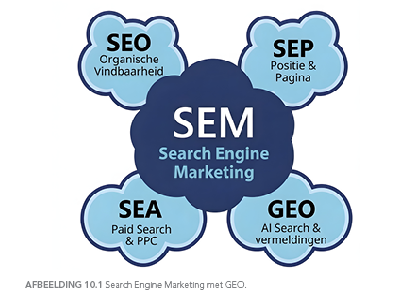
In de moderne online marketing is het niet meer genoeg om alleen goed te scoren op traditionele zoekwoorden. Zoekmachines zoals Google en slimme AI-chatbots (zoals ChatGPT en Perplexity) lezen webpagina’s op een heel andere manier dan vroeger. Om ervoor te zorgen dat zowel traditionele zoekmachines als AI-systemen jouw content feilloos begrijpen, maak je gebruik van gestructureerde data en Generative Engine Optimization (GEO).
Wat is Gestructureerde Data (Schema.org)?
Gestructureerde data is een gestandaardiseerde stukje code dat je aan de achterkant van je website toevoegt. Je kunt het zien als een digitale badge of een duidelijke handleiding voor webcrawlers. In plaats dat de zoekmachine zelf moet gissen waar een tekst over gaat, vertel je met Schema.org exact wat de inhoud betekent. Denk hierbij aan specifieke onderdelen zoals:
-
Producten: Prijzen, voorraad en recensies.
-
FAQ’s (Veelgestelde vragen): Vragen en directe antwoorden.
-
Recepten: Bereidingstijd, ingrediënten en voedingswaarden.
-
Reviews: Sterrenbeoordelingen en klantervaringen.
Meer informatie over de standaarden hiervan vind je op de officiële website van Schema.org of in de Google Search Central Documentatie over Gestructureerde Data.
Waarom is het cruciaal voor SEO én GEO?
De toevoeging van gestructureerde data heeft twee grote voordelen voor jouw online zichtbaarheid:
-
Verrijkte zoekresultaten in traditionele zoekmachines: Door Schema.org toe te voegen, vergroot je de kans op zogenaamde rich snippets in Google. Je resultaat valt direct op doordat er bijvoorbeeld direct sterrenbeoordelingen, prijzen of FAQ-uitklappers onder je link verschijnen. Dit zorgt voor een hogere doorklikratio (CTR).
-
Optimale citatie in AI-chatbots (GEO): Generative Engine Optimization (GEO) richt zich specifiek op het vindbaar en citeerbaar worden binnen AI-gegenereerde antwoorden. AI-modellen zoeken naar hapklare, glasheldere feiten en entiteiten. Dankzij gestructureerde data kunnen taalmodellen jouw content direct ‘begrijpen’, extraheren en opnemen als betrouwbare bron in hun antwoorden.
Wil je dieper duiken in hoe zoekmachines en AI-platformen omgaan met optimalisatie? Bekijk dan de handige artikelen en handleidingen op Search Engine Journal of lees meer over de werking van AI-zoekresultaten op Semrush GEO Guide.
Wie wil dat zijn website opvalt in zowel de klassieke zoekresultaten als de antwoorden van moderne AI-assistenten, kan niet meer om gestructureerde data heen. Door Schema.org correct toe te passen, geef je jouw content een duidelijke structuur waardoor zoekmachines en AI-modellen je direct begrijpen, waarderen en aanbevelen aan de gebruiker.
Gestructureerde Data en GEO – Het Toekomstige SEO
1. Het Veranderende Zoeklandschap: Van Google naar AI
In de moderne online marketing is het niet meer genoeg om alleen goed te scoren op traditionele zoekwoorden. Het zoeken zelf ondergaat een radicale transformatie. Zoekmachines zoals Google en slimme AI-chatbots (ChatGPT, Perplexity, Claude, Gemini) lezen webpagina’s op een fundamenteel andere manier dan vroeger. Waar traditionele Google Search vooral naar woorden kijkt en links telt, begrijpen AI-modellen betekenis en context. Ze willen niet alleen weten wat er op een pagina staat, maar ook: Is dit betrouwbaar? Komt dit van een expert? Kan ik dit citeren als feit? Deze verschuiving vereist een nieuwe benadering van SEO – één die gericht is op beide systemen tegelijk.
2. Gestructureerde Data: De Digitale Badge voor Zoekmachines
Wat is het eigenlijk?
Gestructureerde data is een gestandaardiseerde stukje code die je aan de achterkant van je website toevoegt – meestal in het <head>-gedeelte of verspreid door je HTML. Je kunt het zien als een digitale badge of een duidelijke handleiding voor webcrawlers. In plaats van dat de zoekmachine zelf moet gissen waar een tekst over gaat, vertel jij met gestructureerde data exact wat de inhoud betekent. Het is als het verschil tussen een foto van een product zonder beschrijving versus dezelfde foto met uitgebreide informatielabels erop.
Meer informatie vind je op de officiële website van Schema.org, waar alle standaarden zijn gedocumenteerd.
3. Schema.org: De Standaard voor Gestructureerde Data
Schema.org is de industrie-standaard die door Google, Bing, Yahoo en andere major zoekmachines wordt ondersteund. Deze organisatie beheert een uitgebreide bibliotheek van “vocabulaire” – gestandaardiseerde labels voor vrijwel alle soorten informatie op het web. In plaats van eigen codering te verzinnen, volg je Schema.org’s conventies. Dit zorgt ervoor dat je markup altijd herkend wordt, ongeacht welke zoekmachine of AI-systeem het leest.
Je kunt Schema.org-code op verschillende manieren implementeren:
- JSON-LD (JavaScript Object Notation for Linked Data) – het meest aanbevolen formaat
- Microdata – HTML-attributes voor inline markup
- RDFa – een ander RDF-formaat
Google prefereert JSON-LD omdat het schoon en makkelijk te onderhouden is. Voor implementatie en voorbeelden, zie de Google Search Central Documentatie.
4. Praktische Voorbeelden: Wat kun je Labelen?
Gestructureerde data is niet beperkt tot één type informatie. Vrijwel alles op je website kan voorzien worden van duidelijke labels. Hier zijn de meest waardevolle voorbeelden:
- Producten: Prijzen, voorraad, beschikbaarheid, kleur, maat, reviews en beoordelingen
- FAQ’s (Veelgestelde vragen): Vragen en directe antwoorden – Google toont deze vaak als uitklapbare snippets
- Recepten: Bereidingstijd, ingrediënten, voedingswaarden, yields en reviews
- Reviews en beoordelingen: Sterrenbeoordelingen, klantervaringen, aantal reviews
- Bedrijfsgegevens: Naam, adres, telefoonnummer, openingstijden, locatie op kaart
- Video’s: Titel, beschrijving, duur, thumbnail, upload-datum
- Artikel/Blog: Publicatiedatum, auteur, inhoud, afbeelding, gewijzigde datum
- Evenementen: Datum, locatie, beschrijving, tickets
Voor elke categorie biedt Schema.org specifieke velden. Dit zorgt ervoor dat je niet alleen de informatie opslaat, maar deze ook betekenis geeft aan zoekmachines.
5. Voordelen voor Traditionele SEO: Rich Snippets en Zichtbaarheid
Het eerste grote voordeel van gestructureerde data is zichtbaarheid in Google. Door Schema.org correct toe te voegen, vergroot je de kans op zogenaamde rich snippets – verrijkte zoekresultaten met extra informatie.
Wat zijn rich snippets?
In plaats van alleen een titel, URL en beschrijving te tonen, laat Google nu bijvoorbeeld:
- Gele ★★★★☆ sterrenbeoordelingen rechtstreeks in het zoekresultaat
- Prijzen en voorraadinformatie voor producten
- Recepttijd en ingrediënten samengevat onder een receptlink
- FAQ-uitklappers waar gebruikers vragen kunnen uitvouwen zonder de site te bezoeken
- Video-thumbnails en speelduur
Deze rich snippets maken je resultaat direct opvallen – ze nemen meer ruimte in, zijn visueel interessanter en geven gebruikers al informatie vóór ze klikken. Dit leidt tot een aanzienlijk hogere doorklikratio (CTR) – the percentage users that click your link in search results.
Praktisch voorbeeld: Een artikel over “beste koppelingen voor mountainbikes” met rich snippets toont direct de prijs en 4,8-sterrenrating. Dit trekt veel meer kliks dan dezelfde artikel zonder snippets.
Voor meer informatie over rich snippets zie je Google Search Central Rich Results.
6. GEO: Generative Engine Optimization – Optimalisatie voor AI
Een nieuw acroniem voor een nieuw probleem:
Terwijl traditionele SEO zich richt op Google Search, richt Generative Engine Optimization (GEO) zich specifiek op zichtbaarheid in AI-gegenereerde antwoorden. Dit is een cruciale shift. Wanneer iemand ChatGPT vraagt “Wat is de beste koppelingsolie voor mountainbikes?”, zoekt ChatGPT niet in Google’s index – het zoekt in zijn training data en via directe web-fetches. Als jouw content niet citeerbaar en begrijpelijk is, word je nooit opgenomen in dat antwoord.
GEO richt zich op drie dingen:
- Citaatbaarheid: Kan de AI jouw content makkelijk als bron citeren?
- Betrouwbaarheid: Ziet de AI jou als expert op dit onderwerp?
- Structuur: Is je informatie hapklaar en duidelijk georganiseerd?
Gestructureerde data helpt met alles drie. Met JSON-LD schema’s laat je expliciet zien: “Dit artikel is geschreven door een gekwalificeerde auteur”, “Dit product heeft 100+ reviews”, “Dit is origineel onderzoek.”
Voor diepere inzichten in GEO, zie je artikelen op Search Engine Journal en Semrush’s GEO Guide.
7. Hoe AI-Chatbots je Content Gebruiken (en Waarom Structuur Cruciaal Is)
AI-modellen denken anders dan zoekmachines.
Traditionele Google Search crawlt je pagina, indexeert woorden, telt links. Klaar. AI-modellen gaan verder. Ze proberen semantisch je content te begrijpen. Dat betekent niet alleen woorden tellen, maar vragen beantwoorden als:
- Wie is de auteur en wat is hun expertise?
- Hoe oud is deze informatie en is deze nog actueel?
- Zijn er bronnen of bewijs voor deze claims?
- Hoe betrouwbaar is deze bron vergeleken met anderen?
- Is dit origineel onderzoek of secondair?
Gestructureerde data beantwoordt al deze vragen direct. Zonder structuur moet de AI gissen. Met structuur krijgt de AI heldere, machine-leesbare feiten. Dit zorgt ervoor dat:
- Je content sneller herkend wordt als betrouwbare bron
- Je vaker geciteerd wordt in AI-gegenereerde antwoorden
- Je attributie correct gebeurt (jouw website wordt genoemd)
Praktisch voorbeeld: Een cardioloog schrijft een artikel over hartritmestoornissen. Met Schema.org author markup laat hij zien: “Dit artikel is geschreven door Dr. Jan van de Berg, MD, hartspecialist.” ChatGPT ziet dit, erkent de expertise, en citeert het artikel met meer vertrouwen dan een artikel van een generalist zonder credentials.
8. De Combinatie: Waarom Traditionele SEO + GEO Samen Nodig Zijn
Veel marketeers vragen zich af: “Moet ik kiezen tussen Google-optimalisatie en AI-optimalisatie?” Het antwoord is nee – je hebt beide nodig.
Google’s zoekresultaten zijn nog steeds de voornaamste bron waar gebruikers informatie vinden. Tegelijk groeit AI exponentieel. In 2024 gebruiken miljoenen mensen ChatGPT, Gemini en Perplexity als hun eerste “zoekmachine”. Deze trend zal alleen maar groeien. Door gestructureerde data correct toe te passen, optimaliseer je voor beide systemen tegelijk.
De mooie ironie: gestructureerde data maakt je site beter voor allebei. Rich snippets in Google → hogere CTR. Duidelijke schema’s voor AI → meer citaties in AI-antwoorden. Het is een win-win.
9. Praktische Implementatie: Hoe Begin Je?
Stap 1: Audit je website
Bepaal welke soorten content je hebt. Blog posts? Producten? Recepten? Voor elk type Schema.org-vocabulaire beschikbaar is.
Stap 2: Kies je implementatie
Voor de meeste websites is JSON-LD het beste:
json
{
  "@context": "https://schema.org/",
  "@type": "Article",
  "headline": "Beste koppelingen voor mountainbikes",
  "author": {
    "@type": "Person",
    "name": "Jan van de Berg",
    "jobTitle": "Fietsexpert"
  },
  "datePublished": "2024-09-12",
  "image": "https://site.nl/image.jpg"
}
Stap 3: Test je markup
Google biedt gratis tools:
Stap 4: Monitor resultaten
Controleer in Google Search Console of je rich snippets verschijnen. Vergelijk CTR voor pagina’s met en zonder schema.
Voor stap-voor-stap handleidingen, zie je Google Search Central Structured Data Guide.
10. Toekomst: Schema.org Evolueert met AI
Schema.org blijft groeien en veranderen.
Als AI belangrijker wordt, voegt Schema.org nieuwe vocabulaire toe gericht op AI-readiness. Recent zijn bijvoorbeeld vocabulaire voor “expertise”, “citations”, en “origineel research” toegevoegd. Dit zijn precies de signalen die AI-modellen zoeken.
Voor marketeers betekent dit: gestructureerde data is niet iets dat je eenmalig doet en vergeet. Het is een voortdurend proces van:
- Updates uitvoeren als Schema.org evolueert
- Je content en auteur-informatie actueel houden
- Rich snippets monitoren in Google
- AI-mentions van je content volgen
Wie nu investeert in gestructureerde data – en GEO-principes toepast – zal in 2025 en daarna een duidelijk voordeel hebben. Jouw content zal sneller gevonden worden door Google, en vaker geciteerd door AI-systemen. Dat is de toekomst van online zichtbaarheid.